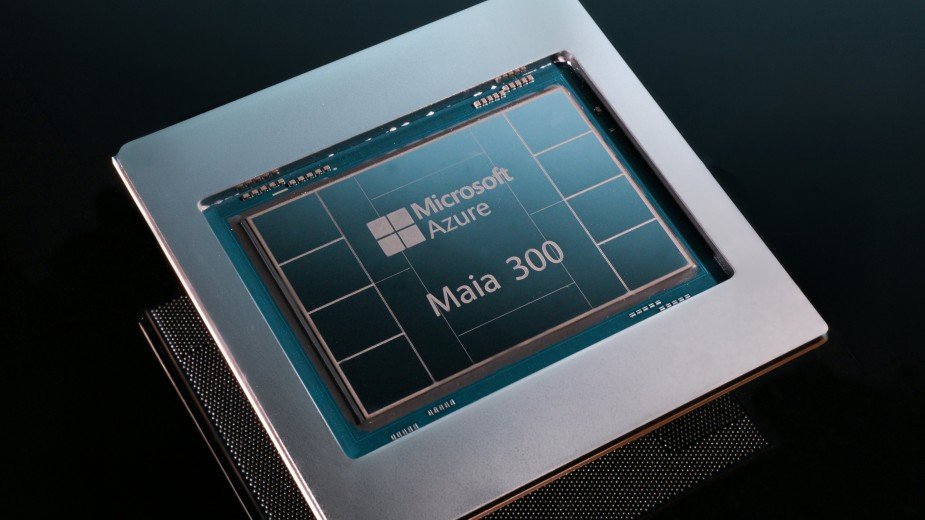
Microsoft szykuje kolejny krok w uniezależnianiu się od układów Nvidii. Nowy akcelerator sztucznej inteligencji Maia 300 ma zapewnić wyższą wydajność przetwarzania modeli i obniżyć koszty ich obsługi w chmurze Azure. Firma zapowiada nawet o 40 proc. więcej przetwarzanych tokenów na megawat w porównaniu z czołowymi systemami opartymi na GPU. Wdrożenie nowego układu zaplanowano na 2027 rok, a jego specyfikacja pokazuje, że Microsoft celuje w naprawdę duże obciążenia.
Firma Microsoft wprowadziła na rynek akcelerator trzeciej generacji, Maia 300, opracowany z myślą o obciążeniach AI. Wdrożenie w środowiskach produkcyjnych planowane jest na 2027 rok. Układ ten ma na celu usprawnienie procesów wnioskowania w swoich produktach i usługach. Dzięki temu nowemu sprzętowi firma planuje zmniejszyć zależność od procesorów graficznych Nvidia i AMD modeli AI.
Maia 300 zwiększy produktywność.
Według Microsoftu, Maia 300 będzie w stanie przetwarzać o 40 procent więcej tokenów na megawat w porównaniu z wiodącymi systemami opartymi na GPU. Konfiguracja racka serwerowego z 96 akceleratorami zapewni nawet 7 razy większą wydajność przetwarzania tokenów w porównaniu z Maia 200.
Firma zaprojektowała platformę Maia 300 dla agentów AI, którzy wykonują rozumowanie w oparciu o długi kontekst, doświadczenia konwersacyjne o niskim opóźnieniu i zadania wieloetapowe. To podejście ma na celu przede wszystkim obniżenie kosztów obliczeniowych niezbędnych do generowania odpowiedzi na pytania użytkowników i uruchamiania modeli AI na dużą skalę.
Microsoft planuje wdrażanie wielogigawatowych rozwiązań Maia w swojej infrastrukturze Azure począwszy od 2027 roku. Firma dąży do tego, aby jej własne akceleratory stały się podstawową platformą do wnioskowania AI w produktach i usługach Microsoft, zmniejszając w ten sposób zależność od firm Nvidia i AMD.

Osiem modułów pamięci HBM4 i przepustowość 18 TB/s.
Wydajność pamięci odgrywa znaczącą rolę w konstrukcji sprzętowej Maia 300. Akcelerator łącznie osiem stosów pamięci HBM4 wykorzystuje i osiąga szczytową przepustowość pamięci na poziomie 18 TB/s. Moc obliczeniowa układu wynosi 950 watów. Microsoft wprowadza również do nowego akceleratora swoją architekturę wielochipletową, która rozdziela jednostki obliczeniowe, kontrolery pamięci i funkcje wejścia/wyjścia. Jednostka obliczeniowa jest produkowana w procesie N2P firmy TSMC. Dystrybucja funkcji pomiędzy oddzielne komponenty pozwala na wykorzystanie specjalnie opracowanych technologii produkcyjnych w każdej sekcji i zwiększa powierzchnię krzemu przeznaczoną na wydajność obliczeniową.
Maia 300 obsługuje również metody obliczeniowe o niskiej precyzji, w tym zaawansowaną technologię MXFP4. Metody te mają na celu zmniejszenie ilości pamięci i narzutu transferu danych wymaganego do obliczeń modelowych, umożliwiając dłuższe okna kontekstowe i przetwarzanie większej liczby żądań w ramach tych samych limitów mocy. Pojedyncza szafa serwerowa będzie zawierać 96 akceleratorów.
Szafa Maia 300 będzie wyposażona w 96 akceleratorów łącznie 27,6 TB pamięci HBM i łączną przepustowość pamięci 1,7 PB/s. Całkowity limit mocy dla tej konfiguracji wynosi 167 kW.
Połączenia o dużej przepustowości między akceleratorami są zoptymalizowane pod kątem paralelizmu tensorowego. Microsoft korzysta również z niestandardowej warstwy transportowej AI opartej na infrastrukturze Ethernet. Pozwala to na skalowanie systemu od pojedynczej szafy serwerowej do wdrożeń w skali centrum danych, eliminując komunikację sieciową jako czynnik ograniczający wydajność obliczeniową.
Maia 300 to następca Maia 200, którą Microsoft ogłosił w styczniu. Akcelerator poprzedniej generacji jest używany w różnych obciążeniach produkcyjnych, w tym w Microsoft 365 Copilot i własnych modelach sztucznej inteligencji firmy. Microsoft rozszerza również wdrożenie Maia 200 w Stanach Zjednoczonych, Europie i Australii.
Według danych udostępnionych przez firmę, Maia 200 może przetwarzać do 1,7 razy więcej tokenów na wat w porównaniu z wiodącymi infrastrukturami GPU, oferując wbudowane funkcje sztucznej inteligencji dla środowisk Teams, Copilot i Cowork. Oczekuje się, że do końca 2026 roku Maia 200 zaczną również być obsługiwane przez usługi GitHub Copilot i Microsoft Foundry. Akcelerator może obsługiwać modele OpenAI, modele MAI firmy Microsoft oraz rodziny modeli open source.

Pokaż / Dodaj komentarze do:
Microsoft ma dość płacenia Nvidii. Szykuje własny układ