
Chłopie, czyś ty na głowę upadł? Bierzesz stronę tego krwiożerczego kapitalisty, który chce odebrać nam RAM, a nawet domowe komputery, tak żebyśmy pracowali tylko na ekranach podłączonych do internetu i ChatGPT oraz ewentualnie zadowalali się streamingiem?
Spokojnie, zaraz wyjaśniam. Przede wszystkim wypowiedź Altmana została wyjęta z kontekstu, chociaż oczywiście w jego przypadku każda wypowiedź tego typu będzie przyjęta bardzo źle. Będąc na jego stanowisku nie można bezrefleksyjnie opowiadać takich rzeczy ludziom, którzy obserwują siedmiokrotne podwyżki pamięci RAM i jeszcze liczyć na poklask. Ale… lećmy po kolei.
Co naprawdę powiedział Altman i czy może mieć rację?
Przypomnijmy, że Altman w trakcie wywiadu powiedział, że z punktu widzenia globalnej gospodarki pamięć RAM lepiej wykorzystać w centrach danych niż w prywatnych komputerach. Dodał (posługując się najpewniej danymi z sufitu, żeby nie powiedzieć dosadniej), że pamięć w komputerach domowych jest wykorzystywana tylko w 5%, a chmura w maksymalny sposób wykorzysta zasoby. No i internet się zagotował.
Wiemy co powiedział Altman, a co ludzie usłyszeli? Że pamięć RAM w komputerach jest niepotrzebna, że ludzie w ogóle nie powinni kupować dużych ilości RAM, że najlepiej zrezygnować z lokalnej AI na rzecz usług chmurowych (w domyśle: ChatGPT).
Wyszło na to, że generalnie Altman uważa, że pamięć RAM należy się centrom danych, a nie jakiemuś plebsowi, który będzie ją używał do grania w Heroes III.
W kontekście Altmana - czyli jednej z osób odpowiedzialnych pośrednio za globalny kryzys na rynku półprzewodników - reakcję tę można jak najbardziej zrozumieć, chociaż była ona zdecydowanie przesadzona. Sam Altman nie mówił o wprowadzeniu zakazu kupna pamięci dla konsumentów, ale o efektywności wykorzystania komponentów, a konkretnie porównywał lokalne modele AI z infrastrukturą chmurową.
Wysyp sprzętu do lokalnej AI
Jasne, centra obliczeniowe AI pożerają RAM w ekspresowym tempie, ale równocześnie powstaje masa niewielkich komputerów do obsługi AI wyposażonych w iście kosmiczne (jak na warunki domowe) pojemności RAM. Duzi gracze (jak MSI, Lenovo, Acer, czy ASUS) skupiają się obecnie na sprzęcie opartym na NVIDIA RTX Spark, który potrafi być wyposażony do 128 GB pamięci, ale na tym bynajmniej lista się nie kończy. Chińscy producenci na przykład do małych stacji roboczych AI upodobali sobie AMD Gorgon Halo (Ryzen AI Max+ serii 400 z Radeonem 8065S) i tylko od września b.r. zapowiedzieli między innymi:
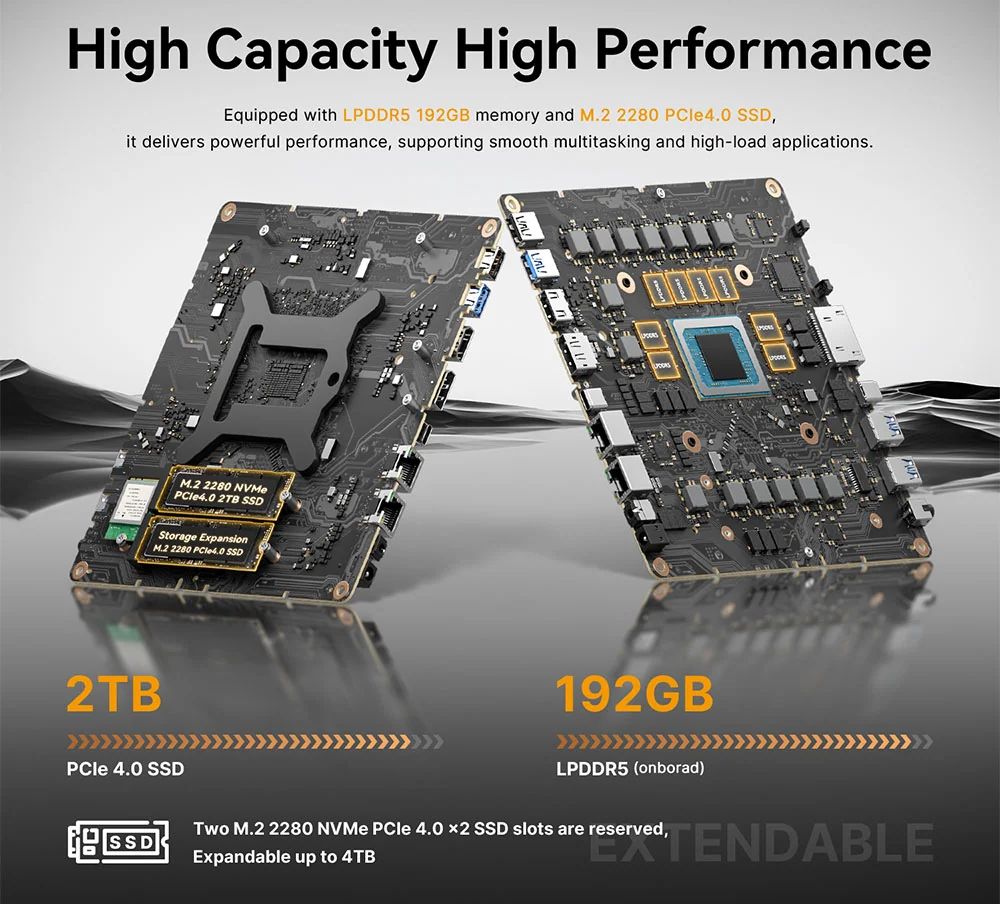
Wnętrze mini PC BOSGAME M5 Max
-
Beelink GTR9 Pro - do 192 GB RAM
-
BOSGAME M5 Max - do 192 GB RAM
-
TOPC TXA2 - do 192 GB RAM
-
PELADN YO2 - do 192 GB RAM
-
AOOSTAR NEX495S - do 192 GB RAM
-
COLORFIRE Lingchuang Mini Pro - do 192 GB RAM
-
CHUWI UniBox AI495 Pro - do 192 GB RAM
-
MINISFORUM MS-S1 MAX-P495 - do 192 GB RAM
-
Acemagic F9A - do 192 GB RAM
Także RAM ląduje nie tylko w centrach danych, ale również jest "pożerany" przez miniaturowe stacje robocze. Czy one jednak faktycznie mają sens?
Dlaczego modele chmurowe są lepsze?
Aktualnie żaden z gigantów AI nie podaje szczegółowych informacji na temat dokładnej liczby parametrów swoich modeli online (płatne modele zamknięte) - precyzyjne dane o wadze modeli są po prostu pomijane. Oczywiście w przypadku modeli dostępnych offline do użytku lokalnego takie informacje są publiczne - na przykład najbardziej zaawansowany model offline'owy model Google'a, czyli Gemma 4 31B to dokładnie 30,7 miliarda parametrów. W teorii taki model zmieści się do 24 GB VRAM, ale biorąc pod uwagę długość kontekstu i inne czynniki, to wypada mieć 32 GB lub wręcz 48 GB VRAM. W każdym razie - to całkiem sporo prawda?
Szacunki ekspertów co do wagi modeli online są jednak bezlitosne - topowe modele Gemini mają mieć nawet do 1,5 biliona parametrów (bilion w polskiej nomenklaturze to 1000 miliardów - nie mylmy z angielskim określeniem bilion, które oznacza miliard). Podobnie jest w przypadku konkurencji - najlepsze modele ChatGPT (OpenAI) mają osiągać do 1,8 biliona parametrów, Opus (Anthropic) do 2 bilionów, a Grok (xAI) do 1 biliona. Oczywiście sama waga to nie wszystko, bo obecne flagowe modele wykorzystują architekturę MoE (Mixture of Experts), czyli podczas generowania pojedynczego tokenu wykorzystują tylko część parametrów - ale mimo wszystko różnica na korzyść zamkniętych i płatnych modeli jest powalająca.
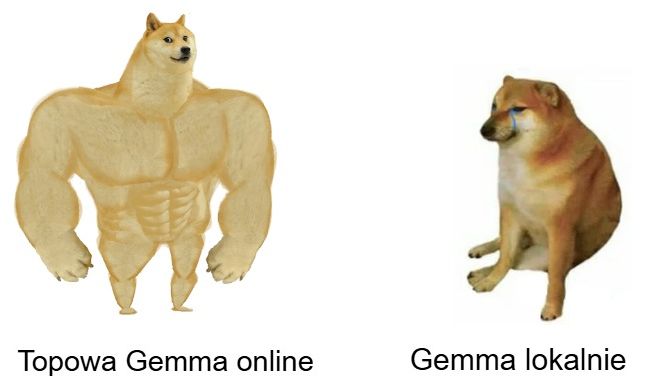
Powtarzam - mowa o najlepszych modelach zamkniętych za płatnymi subskrypcjami. Darmowe wersje Gemini czy ChatGPT to zupełnie inna bajka. Chociaż i w tym przypadku ich twórcy również nie podają wagi modeli, ale z całą pewnością skupiają się na tym, żeby… generowały one jak najmniejsze koszty. Śmiało można więc powiedzieć, że modele uruchamiane lokalnie mogą z nimi bez krępacji konkurować.
Jeśli jednak chcemy mieć dostęp do najlepszych modeli i faktycznie bardzo dobrych możliwości AI, to pozostają nam płatne modele online. Bo czym chcemy z nimi konkurować? Gemmą 4 31B uruchomioną na GeForce RTX 5090? Oczywiście dla wielu użytkowników takie możliwości mogą być w zupełności wystarczające, ale konkluzja jest jedna - modele uruchamiane lokalnie nie mają startu do flagowych modeli online, a koszt domowego sprzętu by je komfortowo używać jest absurdalnie wysoki.
Żeby nie było - też zdarza mi się używać modelu Gemma 4 31B lokalnie, chociaż moja karta graficzna niespecjalnie się do tego nadaje, więc część obliczeń przerzucana jest na procesor i pamięć RAM (orientacyjne działa to z 20 razy wolniej niż na RTX 5090). Zazwyczaj mi się nie spieszy, nie mam problemu z poczekaniem paru minut na odpowiedź, ale z optymalnym działaniem ma to niewiele wspólnego - a i możliwości są ograniczone.
Kiedy modele chmurowe mają sens
-
Gdy regularnie potrzebujemy dostępu do najwyższej klasy modeli
-
Gdy potrzebujemy ogromnej mocy obliczeniowej (które mogą zapewnić tylko serwerownie)
-
Gdy nie chcemy lub nie możemy wydać kupy szmalu w lokalne stacje do przetwarzania AI
-
Zależy nam na wygodzie (dostęp z każdego urządzenia) i współpracy z innymi użytkownikami
Kiedy modele lokalne mają sens
-
Gdy nie potrzeba nam super zaawansowanych modeli, bo nasze potrzeby zaspokoją te o mniejszej wadze i możliwościach
-
Gdy operujemy na poufnych lub prywatnych danych (dokumenty objęte klauzulą poufności, wrażliwe dane np. klientów, czy osobiste materiały)
-
Gdy nie chcemy płacić za każde zapytanie
-
Gdy chcemy pracować offline i mieć pełną kontrolę nad modelem
Ram Altman nie chce zabrać wam pamięci
Co innego miał powiedzieć szef OpenAI? Altman po prostu promuje rozwiązania własnego biznesu. Później tłumaczył się ze swoich słów, że nie jest przeciwnikiem posiadania dużej ilości RAM przez użytkowników, ale również się z nich nie wycofał. A powiedział generalnie prawdę - pamięć RAM w scentralizowanej infrastrukturze AI jest wykorzystywana efektywniej, niż rozproszona w prywatnych komputerach.
Z tego wszystkiego wynikają trzy rzeczy. Po pierwsze, chmurowe modele zawsze będą lepsze - oczywiście mówimy o wersjach płatnych, bo te darmowe mają być z założenia po prostu tanie i nie generować zbyt dużych kosztów. Po drugie, w wielu zastosowaniach wystarczą nam modele lokalne. Po trzecie, policz czy bardziej nie opłaci ci się korzystać z abonamentu AI online, niż inwestować w często bardzo drogi sprzęt do przetwarzania lokalnego.

Pokaż / Dodaj komentarze do:
Altman może mieć rację. Ta cała moda na lokalne AI jest dyskusyjna